

前一天已經由 Patroni 建立一台主節點(Primary)與兩台複本節點(Replica)。今天沿著一次完整的角色變更往下看:PostgreSQL 提升複本節點後如何產生新的時間軸(Timeline)、Patroni 如何選出唯一可寫節點,以及舊 Primary 如何對齊新的預寫式日誌(Write-Ahead Logging,WAL)歷史後回到 Replica 角色。
本文先從 PostgreSQL 的 WAL 與時間軸開始,再比較計畫性切換(Switchover)和故障切換(Failover),接著說明候選節點、隔離(Fencing),以及 PostgreSQL 用來重新對齊分岔資料目錄的 pg_rewind。最後才進入 Lab,分別執行計畫性切換、停止當下的 Primary、確認新 Primary 寫入,並觀察舊 Primary 重新加入。
pg_rewind 與重新初始化分別適合哪一種舊 Primary?本文閱讀方式
- 完整理解技術與底層原理:依序閱讀全文。
- 掌握完成部署所需的基本概念:優先閱讀標有「⭐」的章節。
- 快速了解當天的部署內容:閱讀文末的 Lab/實作章節。
- 跟著系列建立完整系統:依照 GitHub 詳細部署文件 的天數順序操作。
Replica 平時處於復原狀態,接收並重播 Primary 產生的 WAL。此時兩者沿著同一份 WAL 歷史前進。當 Replica 被提升為新的 Primary,PostgreSQL 會結束復原、建立新的時間軸,再從分岔點之後產生新的 WAL。
假設原本所有節點都位於時間軸 1,pg02 被提升後會建立時間軸 2。分岔位置則以日誌序號(Log Sequence Number,LSN)表示:
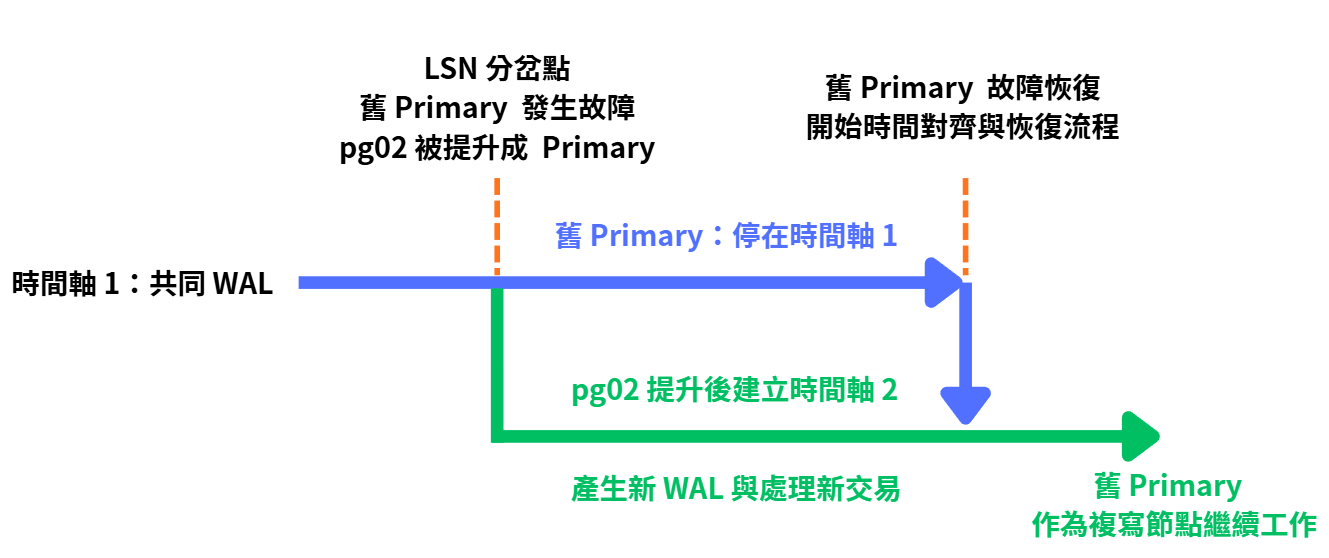
圖(一)Replica 提升後建立時間軸 2。舊 Primary 在故障期間停留於時間軸 1,完成資料對齊後以 Replica 身分跟隨時間軸 2
時間軸 1 會保留為歷史上的父分支。舊 Primary 恢復後必須先確認資料歷史。已經分岔時,會先透過 pg_rewind 或重新初始化對齊資料,再接續時間軸 2。
PostgreSQL 會建立時間軸歷史檔(Timeline History File),記錄父時間軸、分岔位置與切換原因。其他 Replica 讀到這項資訊後,才能從舊時間軸接上新 Primary 的 WAL 歷史。
時間軸編號用來識別 WAL 歷史分支,數字較大只表示後來建立的分支。候選節點是否適合接手,還要同時查看接收與重播位置、複寫延遲、節點標籤及 Patroni 的候選條件。
舊 Primary 若在分岔後繼續產生自己的 WAL,兩邊就會形成不同歷史。串流複寫會沿著選定的時間軸繼續前進,分岔後的兩條寫入歷史需要先選定保留的一側,再讓舊節點透過 pg_rewind 或新的基礎備份對齊。
計畫性切換用於可預期的維護,原 Primary 保持健康並能配合降級。管理者可以先確認候選 Replica 已追上、安排應用程式重連,再由 Patroni 協調原 Primary 降級及候選節點提升。
故障切換用於原 Primary 已失聯或狀態不可信的情況。Patroni 等待原有領導鎖到期,讓合格 Replica 參與領導者競爭。取得新領導鎖的節點才會提升 PostgreSQL。這段等待時間用來區分短暫抖動與持續故障,也讓叢集先確認一致的角色決策。
| 比較項目 | 計畫性切換 | 故障切換 |
|---|---|---|
| 觸發原因 | 維護、升級、演練或主動更換角色 | Primary、程序、主機或網路路徑故障 |
| 原 Primary | 健康並能配合降級 | 失聯、停止或狀態不可信 |
| 候選節點 | 事先選定健康且已追上的 Replica | 由符合條件的 Replica 參與競爭 |
| Patroni 動作 | 協調降級後再提升候選節點 | 領導鎖到期後選出新持有者並提升 |
| 主要風險 | 維護窗口與連線重建 | 未複寫交易、錯誤候選及舊 Primary 殘留寫入 |
| 常見用途 | 作業系統維護、硬體更換及定期演練 | 非預期故障處置 |
兩條流程可以整理成:
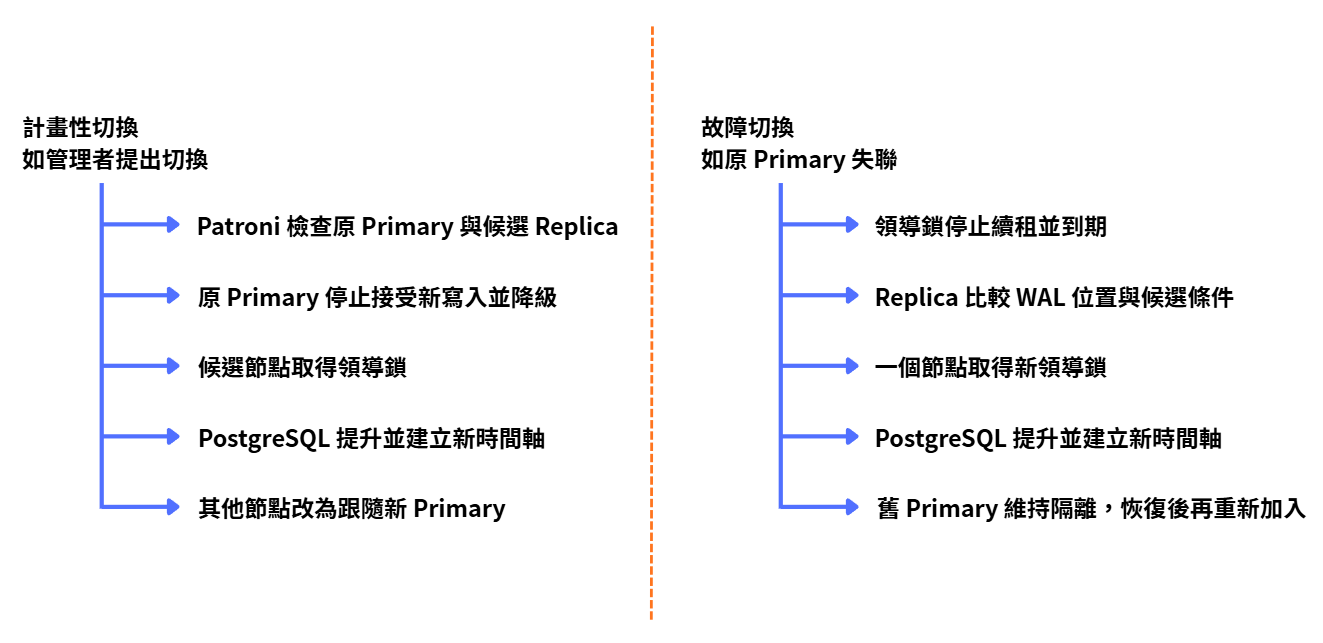
圖(二)計畫性切換先協調原 Primary,故障切換則在領導鎖到期後重新選出 Primary
健康叢集需要更換角色時應使用 switchover。failover 提供原 Primary 已故障時的緊急處置,也允許管理者指定候選節點。手動指定候選節點可能略過自動故障切換採用的複寫落後、時間軸與同步節點保護,因此操作前必須重新確認叢集狀態、候選節點的 WAL 位置與資料歷史。
前一天已說明 Patroni 透過控制迴圈更新 DCS 領導鎖,並以 maximum_lag_on_failover 限制候選節點的複寫落後量。本節進一步把這些機制放入實際故障切換流程,觀察哪些 Replica 具備接手資格、etcd 如何確立唯一領導鎖,以及舊 Primary 如何失去寫入能力。
Patroni 自動選擇候選節點時,會綜合檢查節點是否可達、是否帶有 nofailover 標籤、複寫落後量,以及同步複寫模式要求的候選資格。啟用 check_timeline: true 後,Patroni 還會排除位於舊時間軸的候選節點。
這個延遲門檻是候選資格條件。非同步複寫中,Primary 回覆 COMMIT 時,最新 WAL 可能還在傳送途中。故障切換若選到尚未收到該段 WAL 的 Replica,新 Primary 就可能缺少最後幾筆已確認交易。因此實際資料缺口要以切換前最後確認寫入和切換後可見資料比較,無法直接由 maximum_lag_on_failover 換算成 RPO。
同步模式會要求交易至少到達指定的同步 Replica 後才回覆用戶端,可縮小自動故障切換時的資料缺口。嚴格同步模式(Synchronous Mode Strict)在沒有合格同步 Replica 時停止完成新的同步交易,用寫入可用性換取更明確的資料持久性。前面已介紹這項取捨,今天將它放回候選與故障切換流程中。
取得新領導鎖只完成多數側的角色決策,舊 Primary 還要失去繼續寫入的能力。這裡的 Quorum 指 etcd 叢集取得多數成員同意。Patroni 透過具有 Quorum 的 etcd 提交領導鎖更新。Primary 無法續租領導鎖時,Patroni 會嘗試降級 PostgreSQL。若另外啟用 Linux 看門狗(Watchdog),Patroni 會在具有安全資格時更新計時器。超過安全時限就由看門狗重啟主機,收回舊 Primary 的寫入能力。PostgreSQL 的健康與角色由 Patroni 判斷,看門狗只根據計時器狀態決定是否重啟主機。
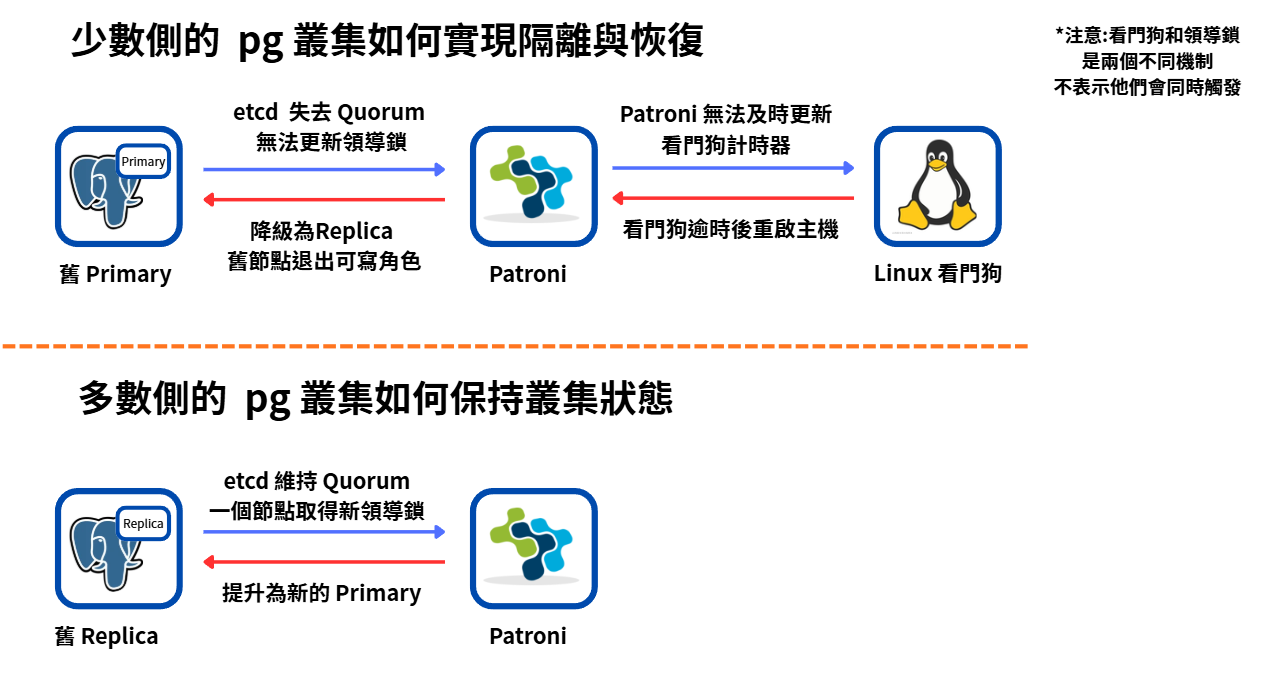
圖(三)Patroni 透過 etcd 多數決更新領導鎖,並透過 PostgreSQL 降級與看門狗逾時重啟收回舊 Primary 的寫入能力
本次 Lab 的實測範圍是以停止 Primary VM 完成故障注入與隔離。圖(三)的看門狗是正式環境可以加入的額外防線。
隔離可以由資料庫程序降級、主機看門狗、虛擬化平台隔離或網路與儲存路徑控制共同完成。設計重點是建立可驗證的停止條件,確保舊 Primary 恢復連線前保持受控狀態。
舊 Primary 重新開機後,Patroni 會先讀取 DCS,確認目前領導鎖已由其他節點持有,再比較本機資料目錄與新 Primary 的時間軸。兩邊已經分岔時,舊節點要先對齊新歷史,才能以 Replica 身分接續串流複寫。
pg_rewind 將舊 Primary 的資料目錄視為目標端,將新 Primary 視為來源端。它會從時間軸歷史找出共同祖先與分岔點,掃描目標端相關 WAL,辨認分岔後被修改的資料區塊,再從來源端複製需要更新的區塊與檔案。資料庫很大、分岔時間短時,這種做法通常比重新取得完整基礎備份更快。
執行 pg_rewind 需要符合下列條件:
wal_log_hints=on。full_page_writes 維持開啟。pg_wal 或 WAL Archive 取得。pg_rewind 專用帳號、pg_hba.conf、TLS 與函式權限允許來源端讀取必要資料。pg_rewind 完成後,舊節點要以復原模式啟動並重播新 Primary 的 WAL,直到追上目前位置。若必要 WAL 已遺失、資料目錄狀態不可信或 pg_rewind 失敗,Patroni 重新初始化會清除該 Replica 的資料目錄,再由新 Primary 建立新的基礎備份。
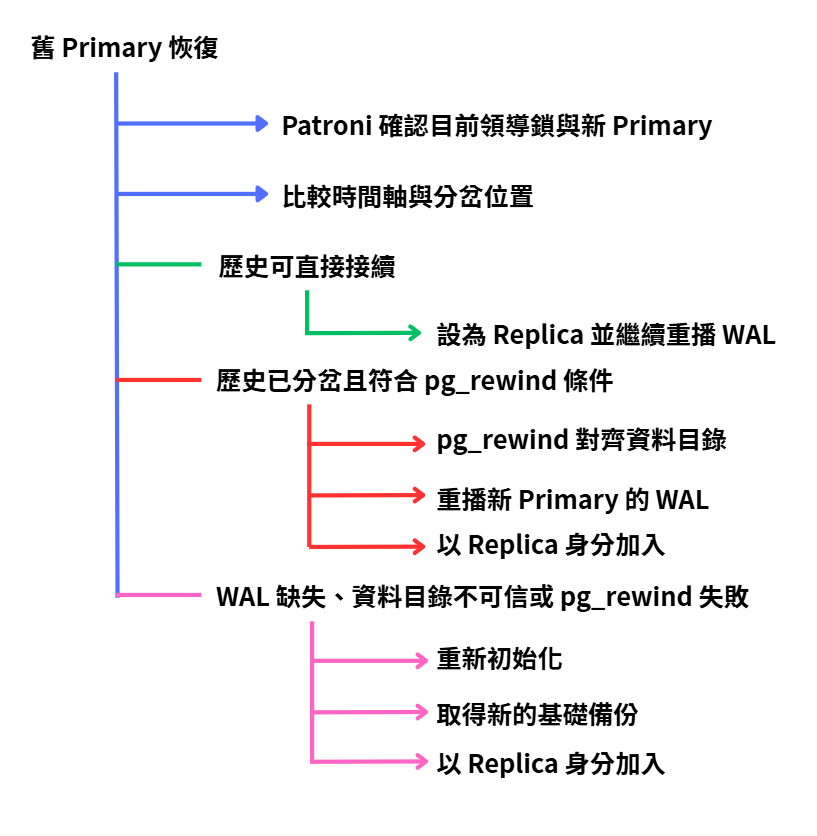
圖(四)舊 Primary 依時間軸與資料目錄狀態選擇直接接續、pg_rewind 或重新初始化
pg_rewind 執行失敗後,目標資料目錄可能停在無法啟動的中間狀態。此時應保留 Patroni 與 PostgreSQL 紀錄,確認來源節點健康,再對已確認為 Replica 的節點執行重新初始化。
PVE HA 觀察 PVE 節點與已納管的 HA 資源。VM 磁碟能由其他節點取得時,才負責在可用節點重新啟動 VM。Patroni 觀察 PostgreSQL、DCS 領導鎖與複寫進度,負責資料庫角色變更。兩層可以同時運作,但恢復完成的判斷點不同:
| 層級 | 判斷依據 | 恢復動作 | 完成狀態 |
|---|---|---|---|
| PVE HA | PVE 節點、已納管資源與隔離結果 | 在其他節點可取得 VM 磁碟時重新啟動 VM | VM 顯示為 started |
| Patroni HA | PostgreSQL 狀態、領導鎖、WAL 位置與候選條件 | 降級、提升、pg_rewind 或重新初始化 |
一個 Primary、其餘 Replica 正常串流 |
本系列刻意讓 pg01~pg03 使用各節點的 local-lvm,並維持 ha: managed 0,由 Patroni 負責資料庫層高可用。本次 Lab 由管理者在原 PVE 節點停止及啟動 pg02,量測範圍集中在 Patroni 與 PostgreSQL。若未來將 VM 磁碟移至共享或複寫儲存,並加入 PVE HA Resource,PVE HA 才會參與 VM 的跨節點恢復。VM 開機時間與資料庫恢復時間應分開記錄。
今天的量測範圍放在 Patroni 與 PostgreSQL:從故障注入開始,到新 Primary 的角色端點回應成功,以及直接連到新 Primary 的第一筆 SQL 寫入成功。代理層完成後,再把固定入口、應用程式重新連線與完整用戶端 RTO 納入量測。
本系列的前置部署已讓 PVE 與 PostgreSQL 節點使用 Chrony。T0 與 T2/T3 由不同主機記錄,因此重現實驗時要先確認兩端時間同步,再計算跨主機時間差。
| 時間點 | 事件 | 取得方式 |
|---|---|---|
| T0 | 送出停止 Primary VM 指令 | 呼叫 PVE API 前立即記錄的時間 |
| T1 | Patroni 判定原領導鎖失效 | Patroni 紀錄 |
| T2 | 新節點取得領導鎖並成為 Primary | patronictl list 與 /primary |
| T3 | 新 Primary 第一筆直接 SQL 寫入成功 | psql 回傳時間與新增資料 |
| T4 | 舊 Primary 以 Replica 身分重新加入 | Patroni 紀錄、角色與複寫狀態 |
T2 - T0 是資料庫角色切換時間,T3 - T0 是直接連線到新 Primary 的可寫恢復時間。舊 Primary 回歸則從送出啟動 VM 指令前立即記錄的時間開始,到 T4 成為可用 Replica 為止。這三個結果具有不同終點,應分欄保存。
資料面還要記錄故障前最後一筆已確認交易,以及新 Primary 上實際可見的最後一筆資料。若兩者一致,可記錄為本次實驗沒有觀察到資料遺失。RPO 需透過多次受控測試、持續編號寫入與既定目標判斷。
正文已經說明時間軸、兩種切換、候選條件與舊 Primary 回歸。本次 Lab 從三節點健康基準開始,先執行一次計畫性切換,再停止切換後當下的 Primary VM 觸發故障切換。最後重新啟動舊 Primary,確認 Patroni 透過 pg_rewind 或重新初始化讓它以 Replica 身分回歸。
GitHub 詳細實作文件:Day 24|PostgreSQL HA 叢集實作(下):計畫性切換、故障切換與舊 Primary 安全回歸
完整文件包含每一步指令、PVE 操作、狀態檢查與回復條件。正文只保留能驗證核心概念的操作與證據。
pg_rewind 前置設定與測試資料。每次只進行一種切換。計畫性切換恢復三節點健康後,才開始 Primary VM 故障實驗。
先在任一 PostgreSQL 節點執行:
sudo -u postgres patronictl -c /etc/patroni/config.yml list -e
確認當下 Leader 與候選 Replica。本次實測 pg03 是 Leader,並選擇 Lag 為 0 的 pg02 作為候選節點,因此執行:
sudo -u postgres patronictl -c /etc/patroni/config.yml \
  switchover iron-pg --leader pg03 --candidate pg02 --force
切換後再次執行 patronictl list -e,並分別查詢新 Primary 與舊 Primary 的 pg_is_in_recovery()、時間軸及測試資料。預期 pg02 成為 Leader,pg03 以 Replica 身分加入,而且三台最終都回到 running/streaming。其他環境執行時要依切換前的實際角色替換 --leader 與 --candidate。
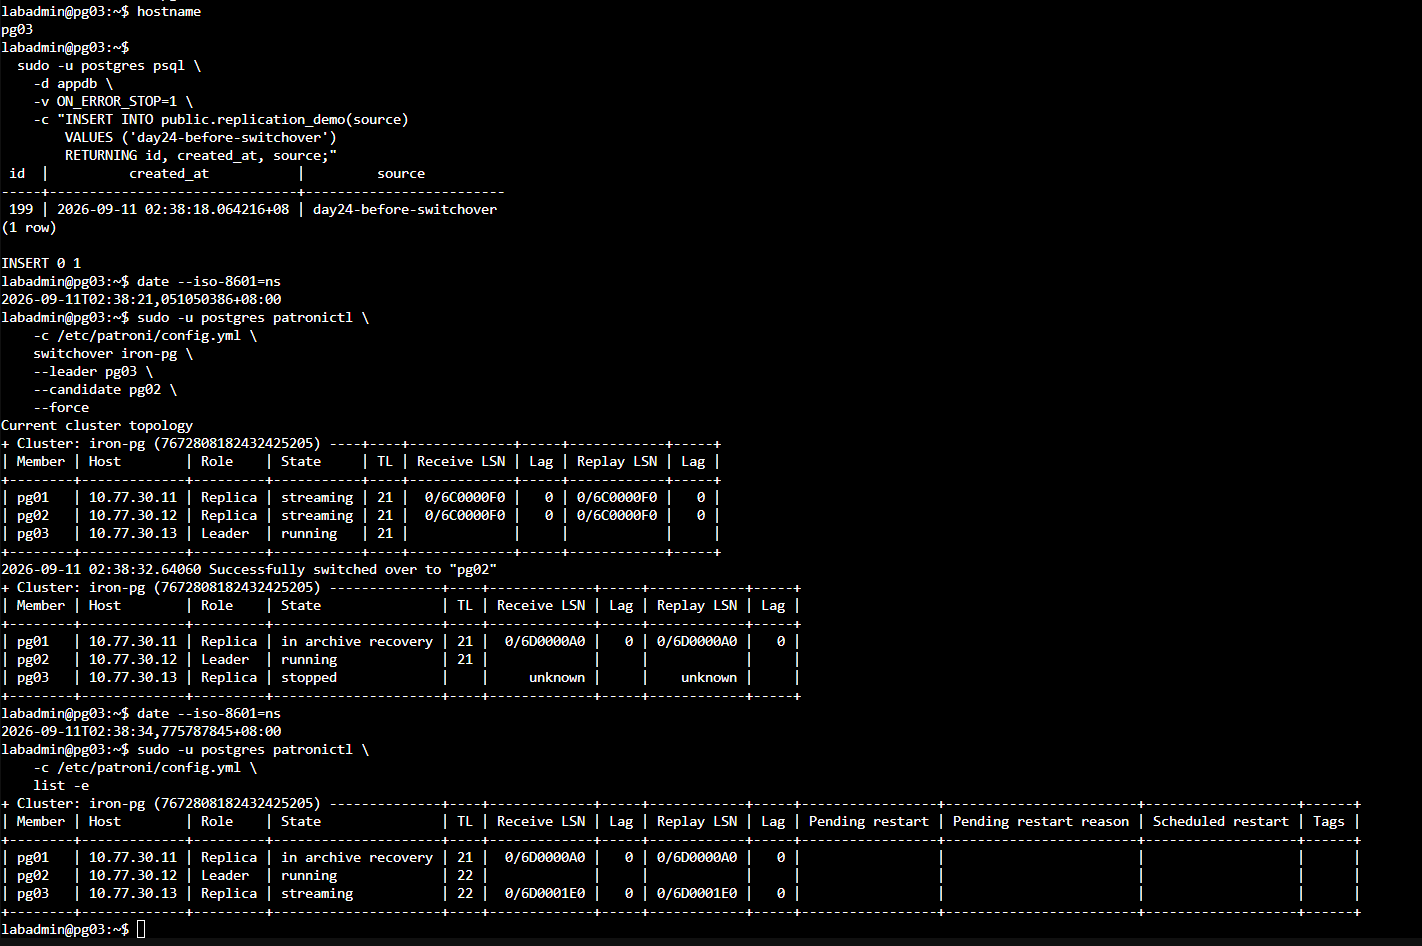
圖(五)切換前 pg03 是時間軸 21 的 Leader。計畫性切換完成後,pg02 成為時間軸 22 的 Leader,pg03 已恢復串流複寫,pg01 當下處於 Archive Recovery。圖(六)的 REST API 後續顯示兩台 Replica 都已恢復 streaming。
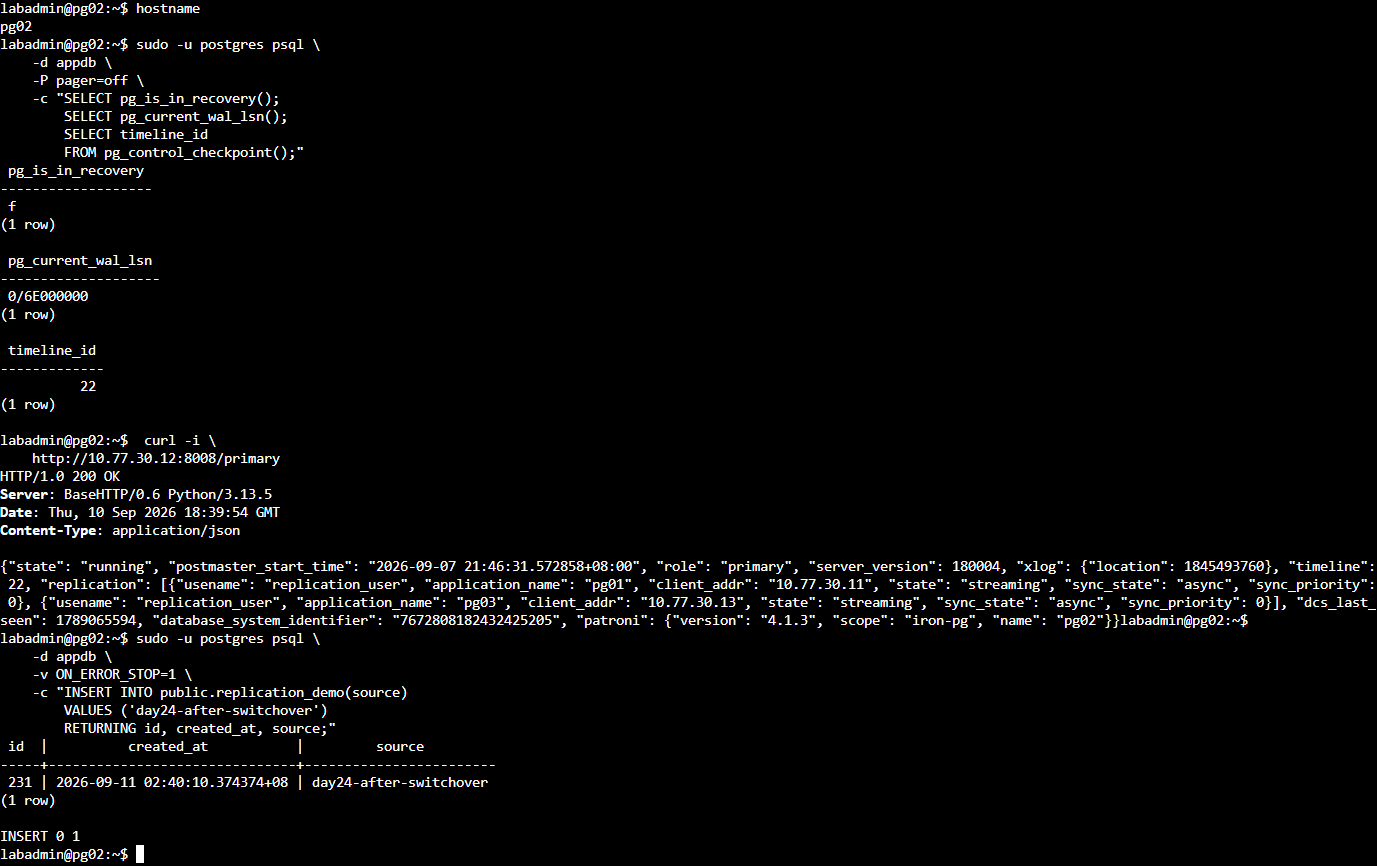
圖(六)pg02 的 pg_is_in_recovery() 為 false、時間軸為 22,/primary 回傳 HTTP 200,並成功寫入切換後的測試資料。
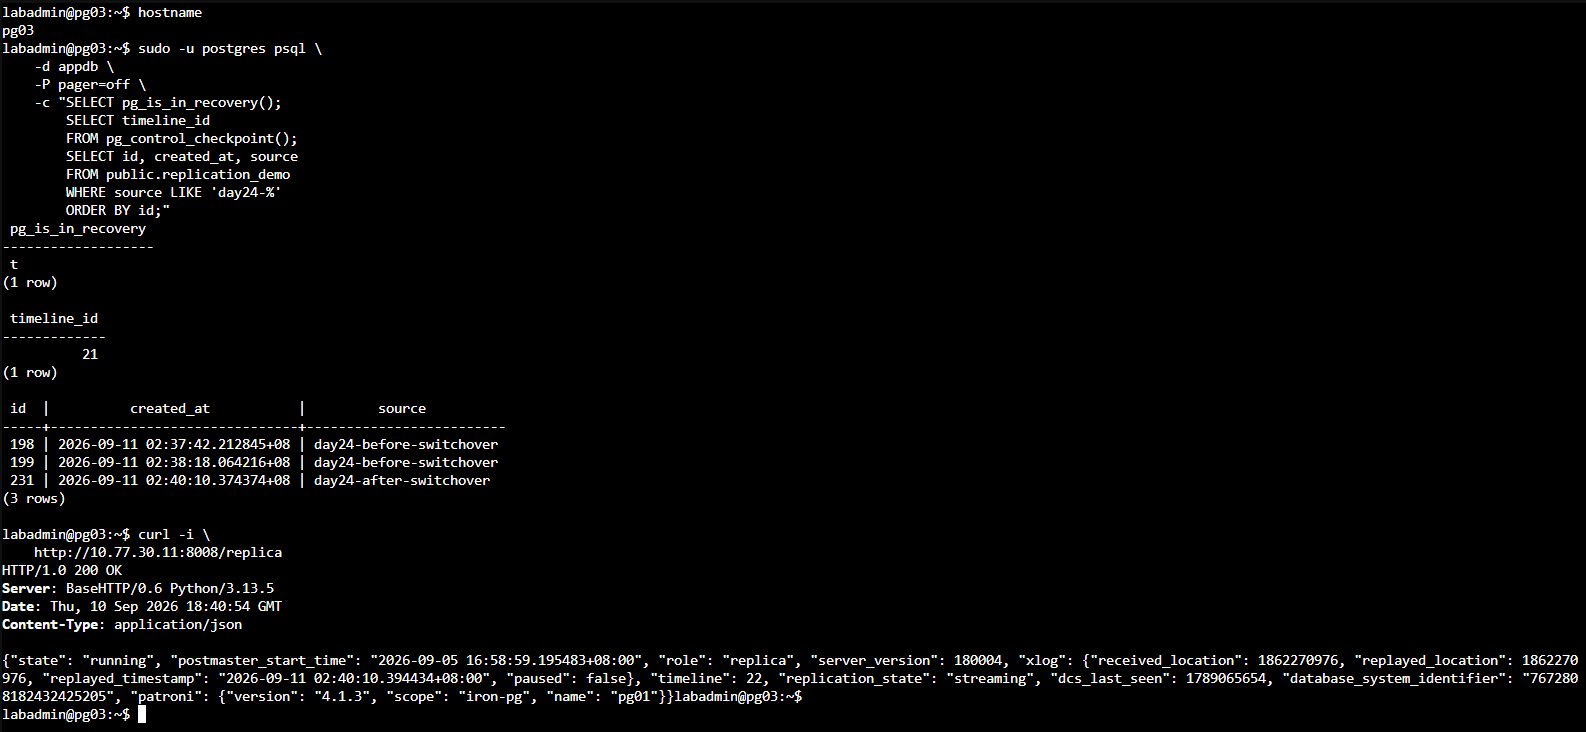
圖(七)原 Primary pg03 的 pg_is_in_recovery() 為 true,並能讀到切換後由 pg02 寫入的資料。畫面中的 pg_control_checkpoint() 顯示上一個檢查點的時間軸 21。圖(五)的 Patroni TL 已顯示 pg03 跟隨時間軸 22。下方 REST API 查詢的是 pg01,用來另外確認另一台 Replica 也在時間軸 22 串流複寫。
先重新讀取 patronictl list -e 找出當下 Leader,並在兩台 Replica 啟動監控:持續查詢各自的 /primary,當端點首次回傳 HTTP 200 時立即嘗試寫入測試資料。確認監控已開始後,再到 PVE 停止當下 Primary 對應的 VM。呼叫停止 VM 的 PVE API 前立即記錄 T0,監控結果則分別提供 T2 與 T3。
新 Leader 出現後,確認只有它的 /primary 回傳 HTTP 200,再直接連到該節點寫入一筆具有 day24-after-failover 標記的資料。其餘存活節點應維持 Replica 角色。
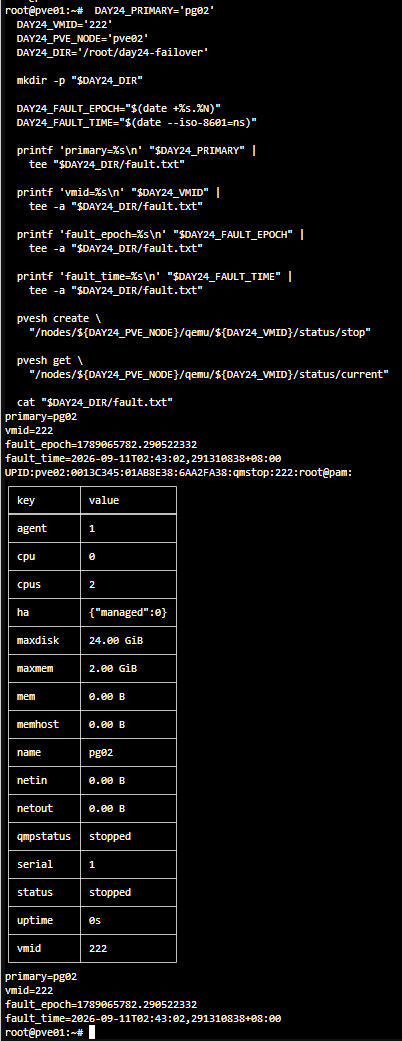
圖(八)在 PVE 停止當下的 Primary pg02,VM 222 顯示為 stopped,故障注入時間為 2026-09-11 02:43:02。
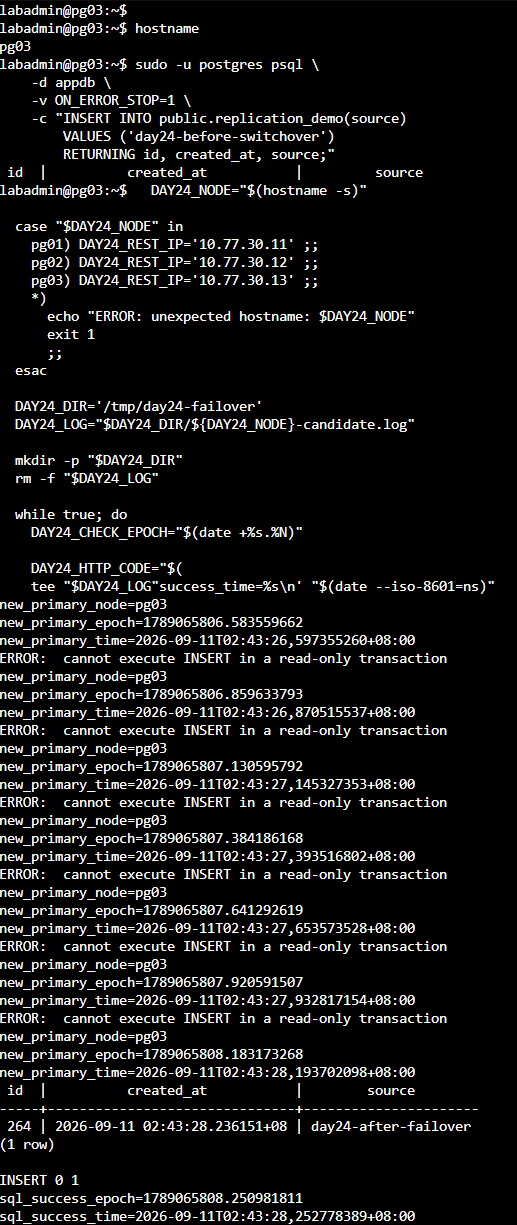
圖(九)pg03 的 /primary 首次回傳 HTTP 200 後,PostgreSQL 短暫處於唯讀狀態。約 1.667 秒後第一筆 SQL 寫入成功。本次截圖中的探測輸出在 SQL 重試時重複列出 new_primary_epoch,T2 採用第一筆。額外實作文件已將角色時間固定在第一筆 HTTP 200。這個結果顯示角色端點恢復與資料庫實際可寫是兩個不同的完成時間。
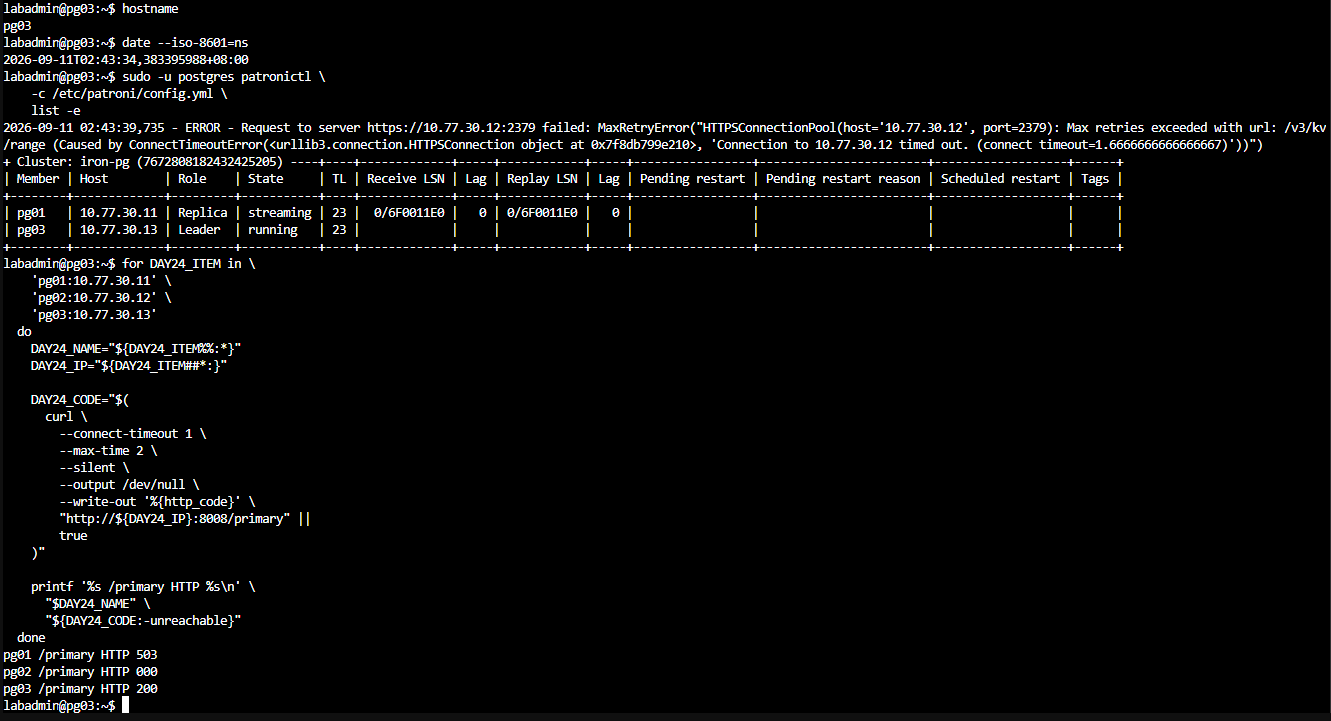
圖(十)pg02 停止後,pg03 成為時間軸 23 的唯一 Leader。三個 /primary 端點中只有 pg03 回傳 HTTP 200,pg01 回傳 503,pg02 無法連線。
這項結果證明 Patroni 在原 Primary 失聯後,透過 DCS 領導鎖只讓一個合格 Replica 取得可寫角色。這個秒數屬於資料庫控制與直接 SQL 路徑。完整 RTO 還要納入代理與用戶端重連時間。
在故障前先寫入一筆可辨識資料並保留成功回傳,再於故障後查詢新 Primary:
SELECT id, created_at, source
FROM public.replication_demo
WHERE source LIKE 'day24-%'
ORDER BY id;
結果應同時列出故障前已確認的資料與故障切換後的新資料。再查詢新 Primary 的時間軸,確認提升後已沿新的 WAL 歷史接受寫入。
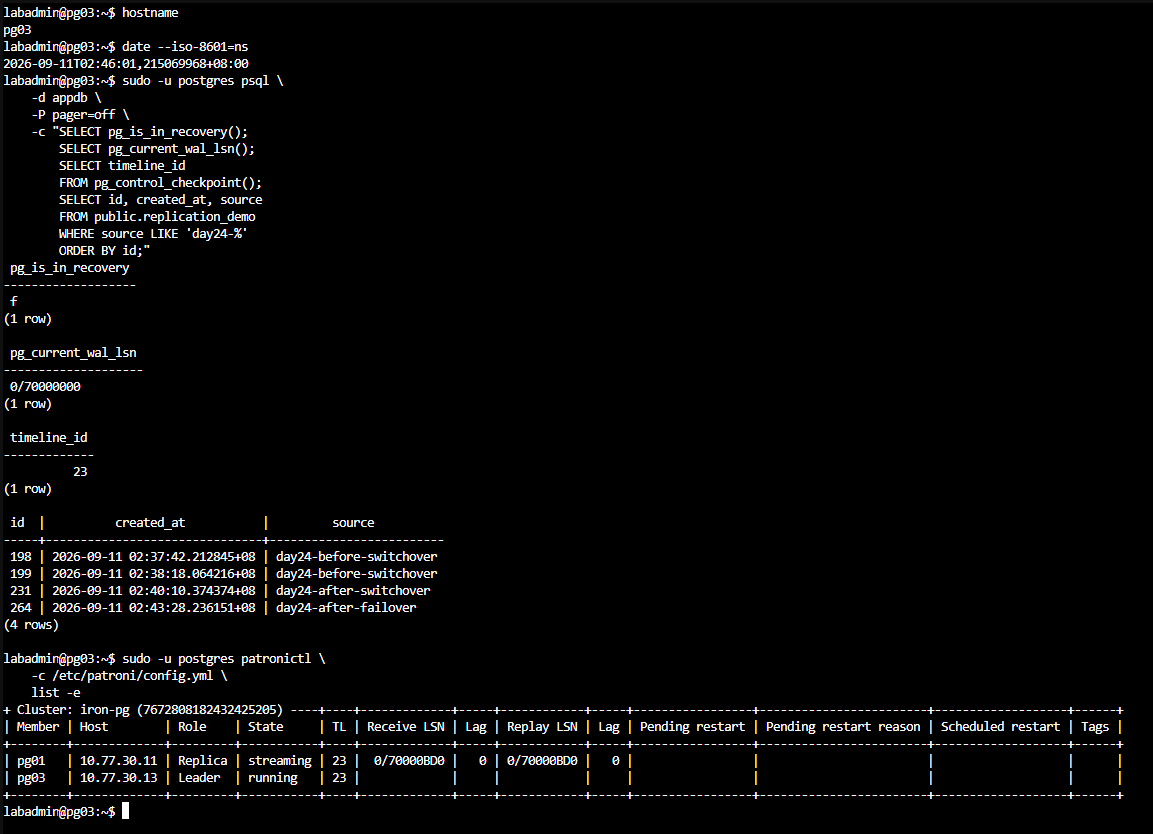
圖(十一)新 Primary pg03 的 pg_is_in_recovery() 為 false、時間軸為 23,並保留計畫性切換前、切換後與故障切換後的測試資料。本次實驗沒有觀察到已確認資料遺失。
這項結果只代表本次故障時間點與複寫進度,後續量測 RPO 時需使用持續編號寫入並重複實驗。
先在存活節點持續查詢舊 Primary 的 /replica,再到 PVE 啟動剛才停止的 VM。呼叫啟動 VM 的 PVE API 前立即記錄起點。舊 Primary 開機後先讓 Patroni 自行處理資料目錄,觀察 Patroni 紀錄是否執行 pg_rewind。當 /replica 首次回傳 HTTP 200 時記為 T4,再確認角色與複寫狀態:
sudo journalctl -u patroni -b -n 100 -o cat --no-pager
sudo -u postgres patronictl -c /etc/patroni/config.yml list -e
sudo -u postgres psql -d appdb -Atqc 'SELECT pg_is_in_recovery();'
預期舊 Primary 回傳 t,並在 patronictl list -e 顯示為 running/streaming 的 Replica。它也應能讀到故障期間由新 Primary 寫入的資料。
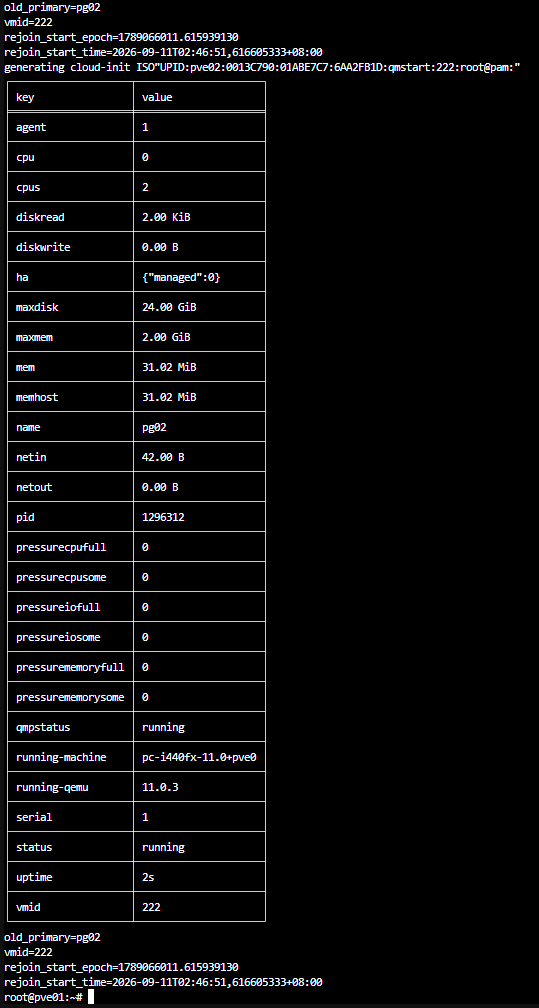
圖(十二)PVE 重新啟動 VM 222,並記錄舊 Primary pg02 的回歸起點為 2026-09-11 02:46:51。
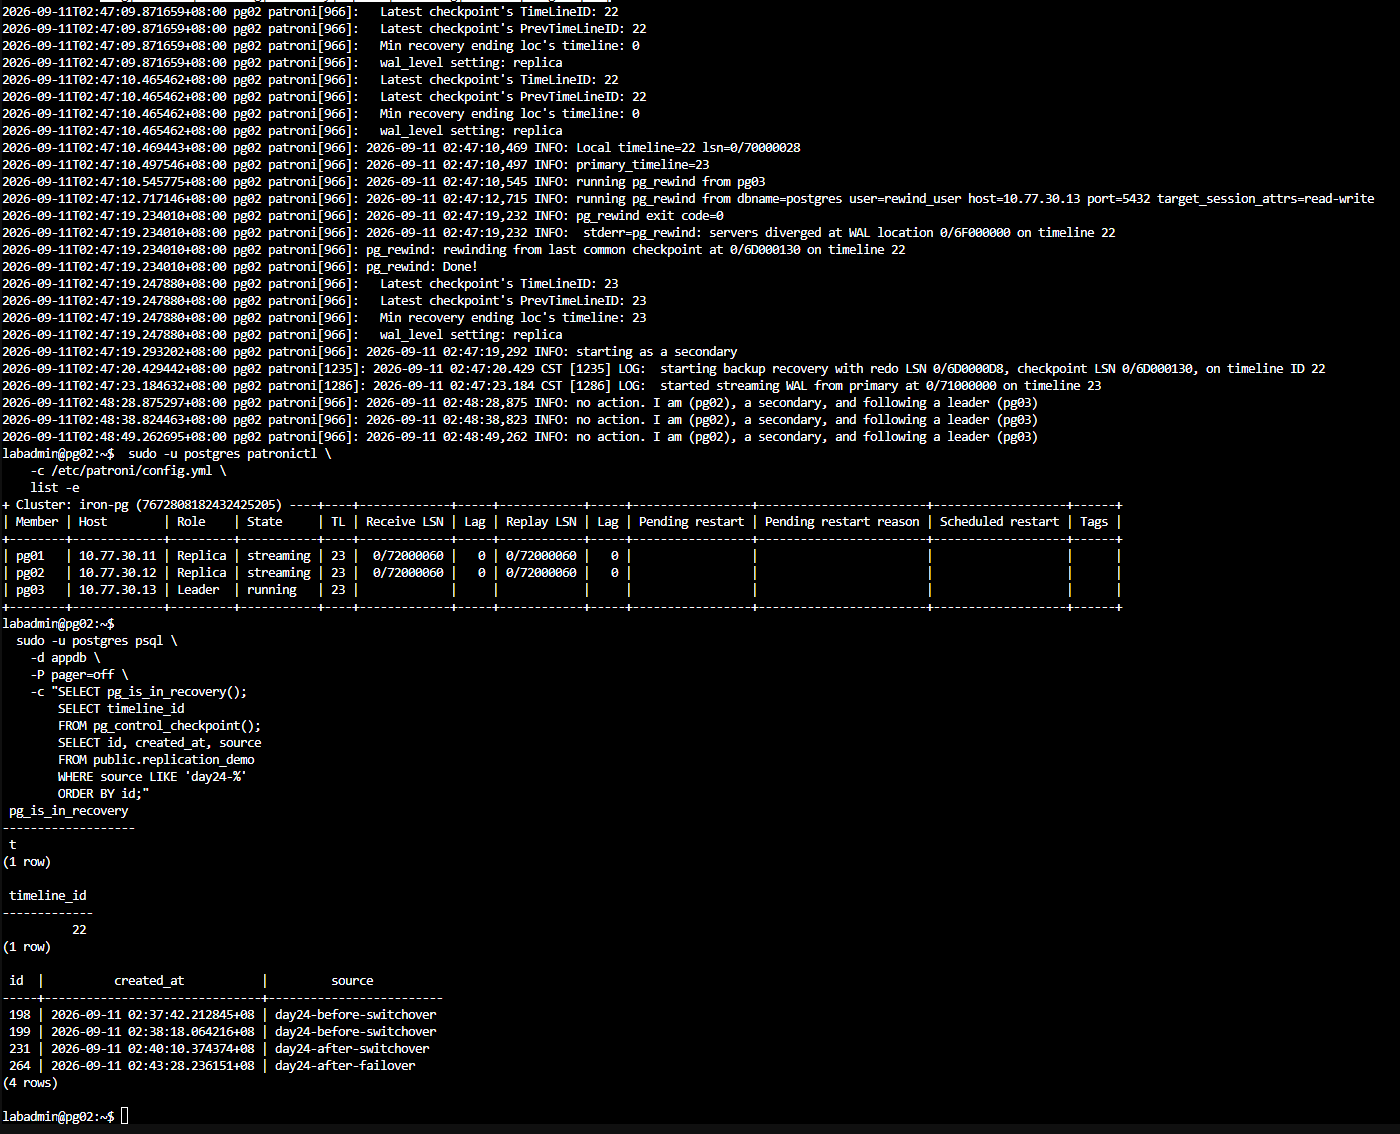
圖(十三)Patroni 判斷 pg02 與新 Primary 的資料歷史已分岔,執行 pg_rewind 對齊資料目錄後,讓 pg02 在時間軸 23 重新開始串流複寫。最終叢集恢復一個 Leader、兩個 Replica 且 Lag 為 0。下方 pg_control_checkpoint() 顯示的是 Replica 上一個檢查點的時間軸,當前串流時間軸以 Patroni TL 與 started streaming WAL ... on timeline 23 紀錄為準。
若舊節點長時間停在 start failed 或 creating replica,先保存紀錄並確認 pg_rewind 專用帳號、HBA、TLS、必要 WAL 與資料頁校驗和。只有在 pg_rewind 條件不足或執行失敗後,才對已確認的 Replica 執行 patronictl reinit。
完成實驗後,將觀察結果整理成:
| 量測項目 | 起點 | 終點 | 本次結果 |
|---|---|---|---|
| 資料庫角色切換 | T0:送出停止 Primary VM 指令 | T2:新 Primary 的 /primary 首次回傳 HTTP 200 |
24.293 秒 |
| 直接 SQL 可寫恢復 | T0:送出停止 Primary VM 指令 | T3:新 Primary 第一筆寫入成功 | 25.960 秒 |
| 舊 Primary 重新加入 | 送出啟動舊 Primary VM 指令 | T4:/replica 首次回傳 HTTP 200 |
97.237 秒 |
| 故障前資料可見性 | 最後一筆已確認寫入 | 新 Primary 查到相同資料 | 本次沒有觀察到資料遺失 |
故障注入、角色端點與 SQL 成功時間可由圖(八)、圖(九)交叉計算。原始監控指令較長,圖片只保留關鍵事件、時間戳與計算所需的數值。
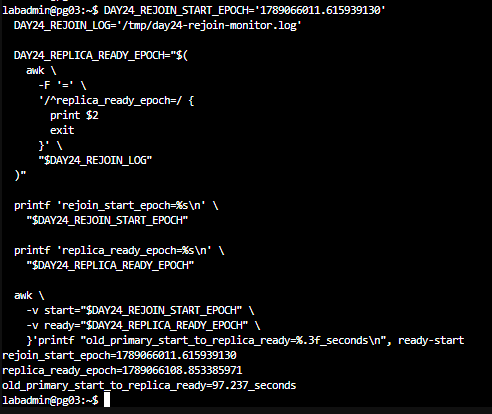
圖(十四)從送出啟動 pg02 VM 指令到其 /replica 首次回傳 HTTP 200 共 97.237 秒。這段時間包含 PVE API 處理與 VM 開機。圖(十三)進一步確認它已完成 pg_rewind 並恢復串流複寫。
| 類型 | 主要證據 | 可以得到的結論 |
|---|---|---|
| 驗證一:計畫性切換 | 切換前後的 Patroni 角色、Recovery 狀態與時間軸 | 本次叢集可以在健康狀態下交換 Primary 與 Replica |
| 證明一:故障切換 | Primary VM 停止、單一新 Leader、/primary 與直接 SQL |
原 Primary 失聯後只有一個 Replica 取得可寫角色 |
| 驗證二:資料歷史 | 時間軸與故障前後測試資料 | 新 Primary 沿新時間軸接受寫入,並可核對本次資料缺口 |
| 驗證三:舊 Primary 回歸 | Patroni 紀錄、Recovery 狀態與複寫延遲 | 舊 Primary 已對齊新歷史並以 Replica 身分加入 |
| 量測 | T0~T4 時間戳 | 角色切換、直接可寫與節點修復是不同的恢復時間 |
pg_rewind 或重新初始化回到 Replica。下一篇是 Day 25|為 Web 與資料庫建立服務入口:Nginx 負載平衡、TLS 邊界與 HAProxy 讀寫分流。我們會在兩台代理節點建立 Web 與資料庫入口,讓 HAProxy 依 Patroni REST API 將新的資料庫連線送往目前 Primary,並確認代理節點各自都能獨立提供服務。


 iThome鐵人賽
 看影片追技術